Base64 编码:什么时候该用,什么时候不该用
Base64 的主要作用不是加密,而是把二进制或特殊字符内容转换成更容易放进文本协议的表示形式。理解这一点,能避免把它误当作安全措施。
Base64 解决的是兼容性问题
邮件、JSON、HTML、CSS 和 URL 参数更适合传输文本。Base64 可以把图片片段、文件内容或二进制数据变成可打印字符,但编码后的内容通常比原始内容更大,因此不适合无节制地塞进所有地方。
Base64 不是加密
任何人都可以轻松解码 Base64 字符串。不要因为字符串看起来不可读,就把密码、令牌、私钥或客户数据当成“已保护”。如果内容本身敏感,应使用真正的加密、权限控制和安全传输方式。
URL 安全变体适合放进链接
标准 Base64 可能包含加号、斜杠和等号,这些字符在 URL 中可能需要额外转义。URL-safe Base64 会替换部分字符,减少链接、查询参数和短 token 在传输中的格式问题。
Data URI 应谨慎使用
把小图标或小片段嵌入 CSS/HTML 时,Data URI 很方便。但较大的图片或文件会让 HTML/CSS 变长,影响缓存、审查和维护。产品代码中最好只对小而稳定的资源使用这种方式。
优先使用本地编码工具
调试 Webhook、复制日志或处理示例数据时,如果内容可能包含内部字段,浏览器端工具是更稳妥的默认选择。它减少了把原始字符串发给第三方服务的机会。
先计算体积代价
Base64 通常把每 3 个输入字节表示为 4 个文本字符,因此编码主体会比二进制原文大约多三分之一,还没有计算换行和 Data URI 前缀。压缩传输可能抵消一部分开销,但不会让大型内嵌资源变成零成本。决定内嵌前,应记录原始字节数、编码字符数和最终压缩响应。
字符编码发生在 Base64 之前
Base64 处理的是字节,不是抽象字符。包含中文、重音字符或 emoji 时,应先明确转换成 UTF-8 字节;解码后也必须使用相同字符集解释。只比较屏幕上看起来是否相同,可能掩盖底层字节已经变化的问题。
可重复的往返测试
- 准备同时包含 ASCII、重音字符、中文和 emoji 的虚构样例。
- 编码前记录 UTF-8 字节长度。
- 按目标系统要求选择标准或 URL 安全变体。
- 使用另一种实现解码。
- 比较解码字节与原始字节,而不只看显示文本。
- 只有目标规范允许时,才测试省略 padding 的形式。
常见失败模式
- 把 URL 安全变体交给严格的标准解码器。
- 把已经编码的文本再次编码。
- 复制时加入换行或空格。
- 把 UTF-8 字节误当成 Latin-1。
- 因为编码后“不像明文”而把密钥写入日志。
- 把 Data URI 的媒体类型和逗号一起送入解码器。
资料来源与复核说明
字符表与 URL 安全变体参考 RFC 4648,Data URI 语法参考 RFC 2397。所有样例均为虚构数据,复核方法见浏览器工具测试说明。
相关工具
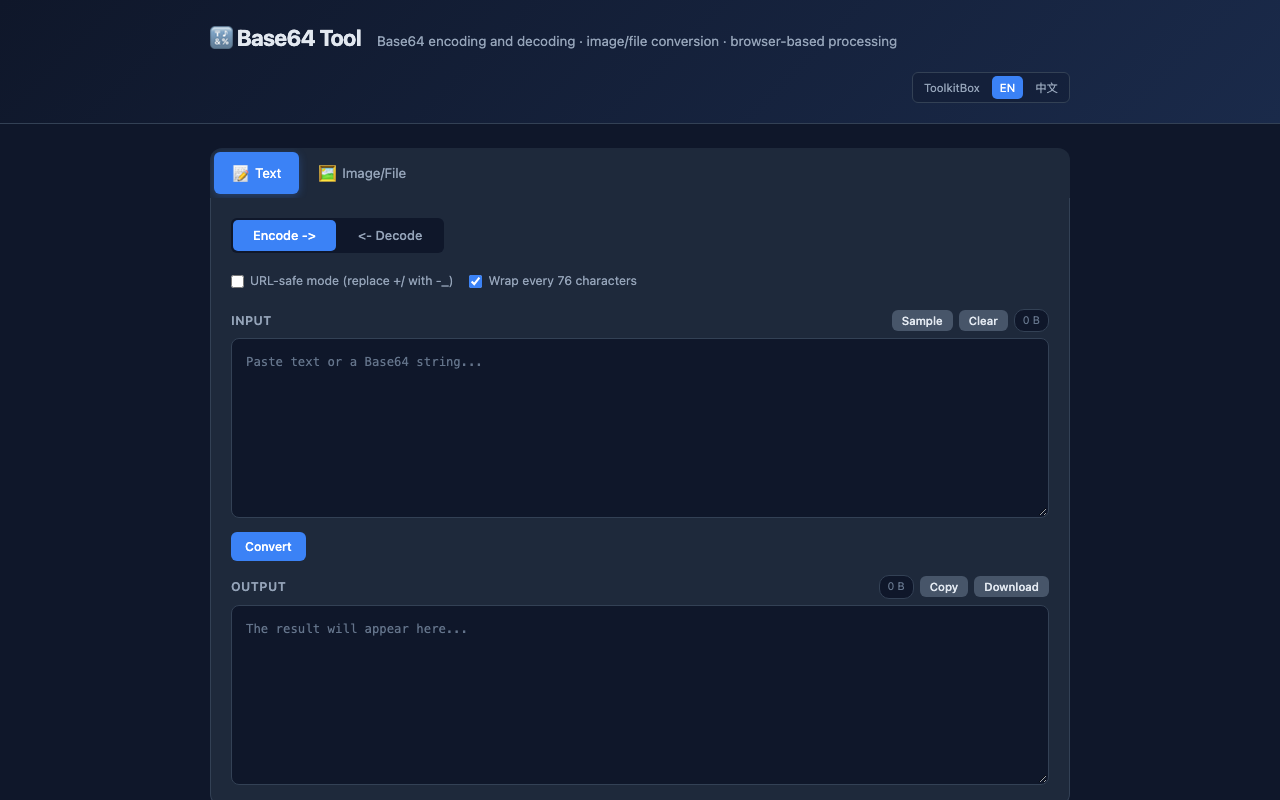
打开 Base64 Tool,在浏览器中编码和解码文本。